PixelDiT → PixelDiT2 → Iris-3B
像素空间的难题与前史
潜变量扩散依赖预训练自编码器,能够节省算力,却引入重建误差;直接在 RGB 中生成,又要面对密集像素和难学的表示。
主线从 PixelDiT 到 PixelDiT2 依次推进。第一篇问:怎样在计算可控的前提下,对像素做足够细的建模?第二篇问:即使算得动,像素扩散为何仍然学得慢?
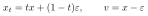
共同背景:像素空间中的 rectified flow;这里 t = 0 对应噪声,t = 1 对应干净图像。
像素序列过长
全图像素 token 上的自注意力代价极高。加大 patch 虽可缩短序列,却损失细粒度像素交互。
语义表示也要现学
直接处理 RGB 时,网络需要同时学会可用于去噪的视觉表示和像素生成,训练收敛较慢。
大 patch 之后,如何把细节还给像素?
在 PixelDiT 之前,DiP 与 DeCo 两篇同期工作已把“全局语义 + 局部像素更新”作为共同的架构问题;它们分别从局部归纳偏置和频率分工出发。
DiT 管全局,U-Net 补局部
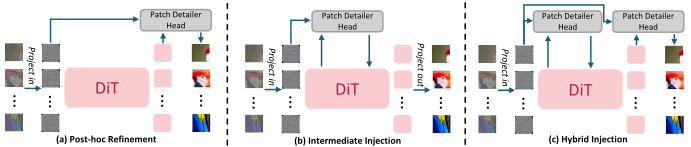
16×16 大 patch 的 DiT 建模跨 patch 结构;逐 patch 的浅层卷积 U-Net 接收噪声像素及对应 DiT 特征,预测局部细节。作者比较细节头的三种接入位置,最终选用接在 DiT 末端的方案。
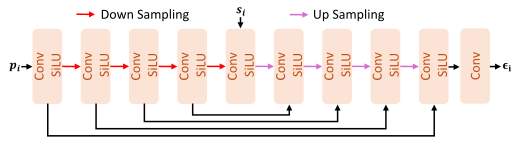
选定接入位置后,细节头在每个 patch 内独立工作;U-Net 的下采样与跳连提供局部纹理归纳偏置,DiT 特征在瓶颈层注入。
DiT 学低频语义,像素解码器补高频
DiT 处理下采样输入;无注意力的逐像素解码器接收全分辨率噪声图,并用 DiT 语义作 AdaLN 条件,预测像素速度。训练时再用 JPEG 量化表加权的 8×8 DCT 损失强调可感知的频率。
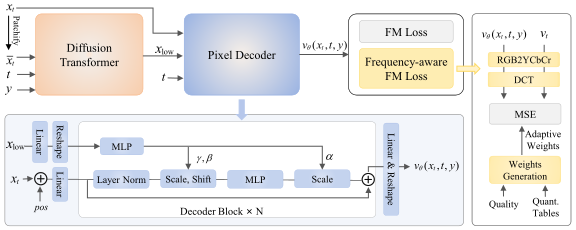
接到 PixelDiT:三者都在分离全局建模与像素更新;PixelDiT 进一步用 patch Transformer + pixel Transformer 的双层架构,并让像素分支保留压缩后的跨 patch 注意力。
PixelDiT:双层 Transformer
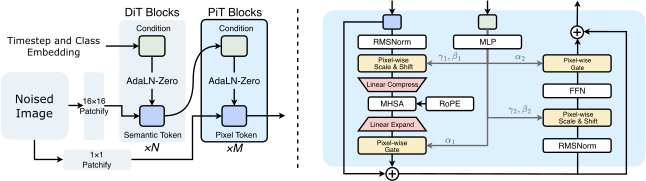
粗尺度 patch 负责全局语义,轻量 pixel 分支负责每个像素的更新。
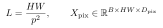
p = 16 时,全局注意力面对 H W / 256 个 patch token;PixelDiT 的 Dpix = 16。
Pixel token compaction
PiT 在注意力前把每个 patch 内 p² 个像素 token 学习式压成一个 token,完成跨 patch 的全局交互后,再展开回像素。逐像素主干和残差连接保留局部信息。
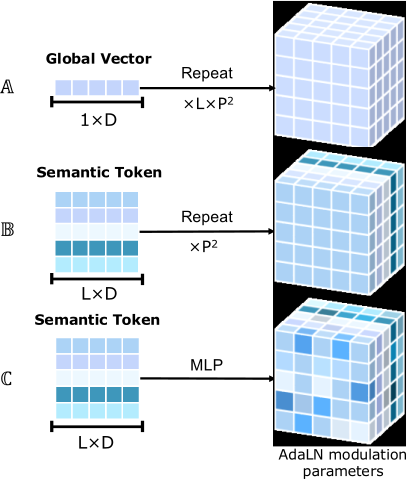
Pixel-wise AdaLN
一个语义 token 经线性映射产生对应 patch 内每个像素各自的六组调制参数,分别控制注意力和前馈层的缩放、平移与门控。
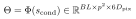
训练使用像素空间 rectified flow 的 velocity matching,并在 patch 分支的中间层加入 REPA 表征对齐。文字生成版本仅在 patch 分支改用多模态 DiT;pixel 分支不直接接收文本 token。
PixelDiT2:把表征先验接入每一步
保留像素空间的生成轨迹,改用单路径 patch denoiser;冻结视觉编码器在采样过程中持续提供空间条件。
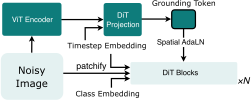
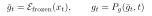
编码器看的是当前 xt,所以推理时每个去噪步都要运行;Pg 学习适配不同噪声强度。
空间对齐的条件
DINOv3 与 denoiser 都以 16×16 为 patch,grounding token 一一对应空间位置。条件通过 spatial AdaLN 作用于 DiT block,区别于 PixelDiT 中 PiT 的逐像素 AdaLN。
先预测干净图,再换算速度
PixelDiT2 输出 x̂;训练损失在 velocity 空间计算,另保留 REPA。CFG 的无条件分支同时丢弃类别和 grounding,避免 DINO 特征泄漏类别信息。
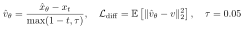
原论文 Eq. (2)–(3)。目标形式变化要与主干和条件路径的变化分别理解。
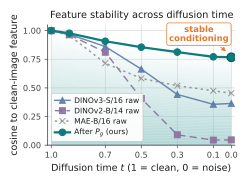
冻结 DINOv3 本身只在干净图像上预训练。直接把它的噪声图特征用于调制存在分布偏移,时间条件投影承担这种适配。
原论文指出,稳定的投影输出并非恢复原始干净图特征,而是形成随时间相对稳定、供去噪器使用的条件。对编码器进行联合或分阶段适配,在报告的设置中都没有超过冻结版本。
Iris-3B:扩展规模,再检验迁移
这篇工作沿用 PixelDiT 的双层像素设计,将文字生图主干扩大到约 30 亿参数,并检验像素生成先验在深度估计和图像复原中的价值。
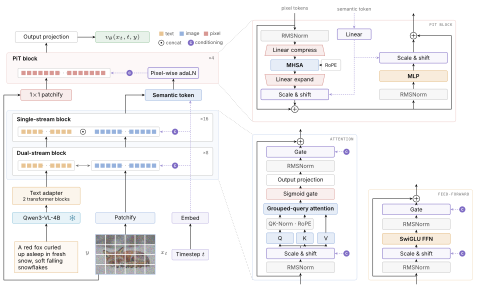
双流接单流
双流层让文字与图像使用各自的投影和前馈权重,在联合 attention 中交互;单流层把两类 token 拼接,使用共享权重继续建模。这是 Iris-3B 借鉴的 FLUX.1 混合结构,具体深度为 8 加 16。
四层 PiT 输出像素
PiT 接收 patch 语义条件,对每个像素做独立调制;跨 patch 的 attention 仍通过每个 patch 压缩得到的一个 token 完成。它延续第一篇的像素头,架构路线与 PixelDiT2 的单路径 patch 去噪器不同。
为扩大模型,主干还引入 20 个 query head 与 5 个 key/value head 的分组查询 attention、sigmoid 门控、前后 RMSNorm,以及跨 block 共享投影并加入每层偏置的时间调制。冻结的 Qwen3-VL-4B 负责文字编码,12 层特征经可学习的层汇聚和两层 refiner 送入生成主干。作者报告共享调制在相同 FLOPs 下比逐层 AdaLN 减少约 28% 的对应模型参数。
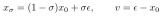
Iris-3B 的噪声参数记为 σ,σ = 1 是纯噪声;符号方向与前文 PixelDiT2 使用的 t 相反。
规模和训练协议
先在 256² 消融 x 与 v 预测及 REPA 等对齐方式,再用 v 预测与 DINOv2 REPA,按 256 → 512 → 1024 分辨率训练并进行精选数据微调。REPA 只用于 256 阶段;最终发布模型在 1024² 的 GenEval 为 0.798,DPG 为 86.52。
像素化转换对照
另将预训练的 FLUX.2 Klein base 4B 去掉 VAE,换成 16×16 RGB patch 输入与 PiT 像素头。作者用岭回归初始化输入映射,并缩小主干学习率,解决初期规则 patch 噪声。这个模型为迁移实验提供共享 FLUX.2 来源的 latent 与 pixel 对照。
| DIV2K / native Real-ESRGAN | PSNR ↑ | SSIM ↑ | LPIPS ↓ | MUSIQ ↑ |
|---|---|---|---|---|
| FLUX.2 Klein latent | 20.99 | 0.557 | 0.275 | 67.11 |
| FLUX.2 Klein pixel | 20.87 | 0.504 | 0.274 | 67.03 |
| Iris-3B pixel | 20.68 | 0.481 | 0.292 | 68.01 |
论文 Table 6。三者均采用 HYPIR 风格的一步复原,损失由像素 MSE、LPIPS 和对抗项组成。FLUX.2 两组使用相同图像对与训练日程,像素版本没有整体优势。Iris-3B 的预训练起点、批量、训练时长、EMA 与推理后处理均不同,因此不能把三行差异归因于像素空间本身。
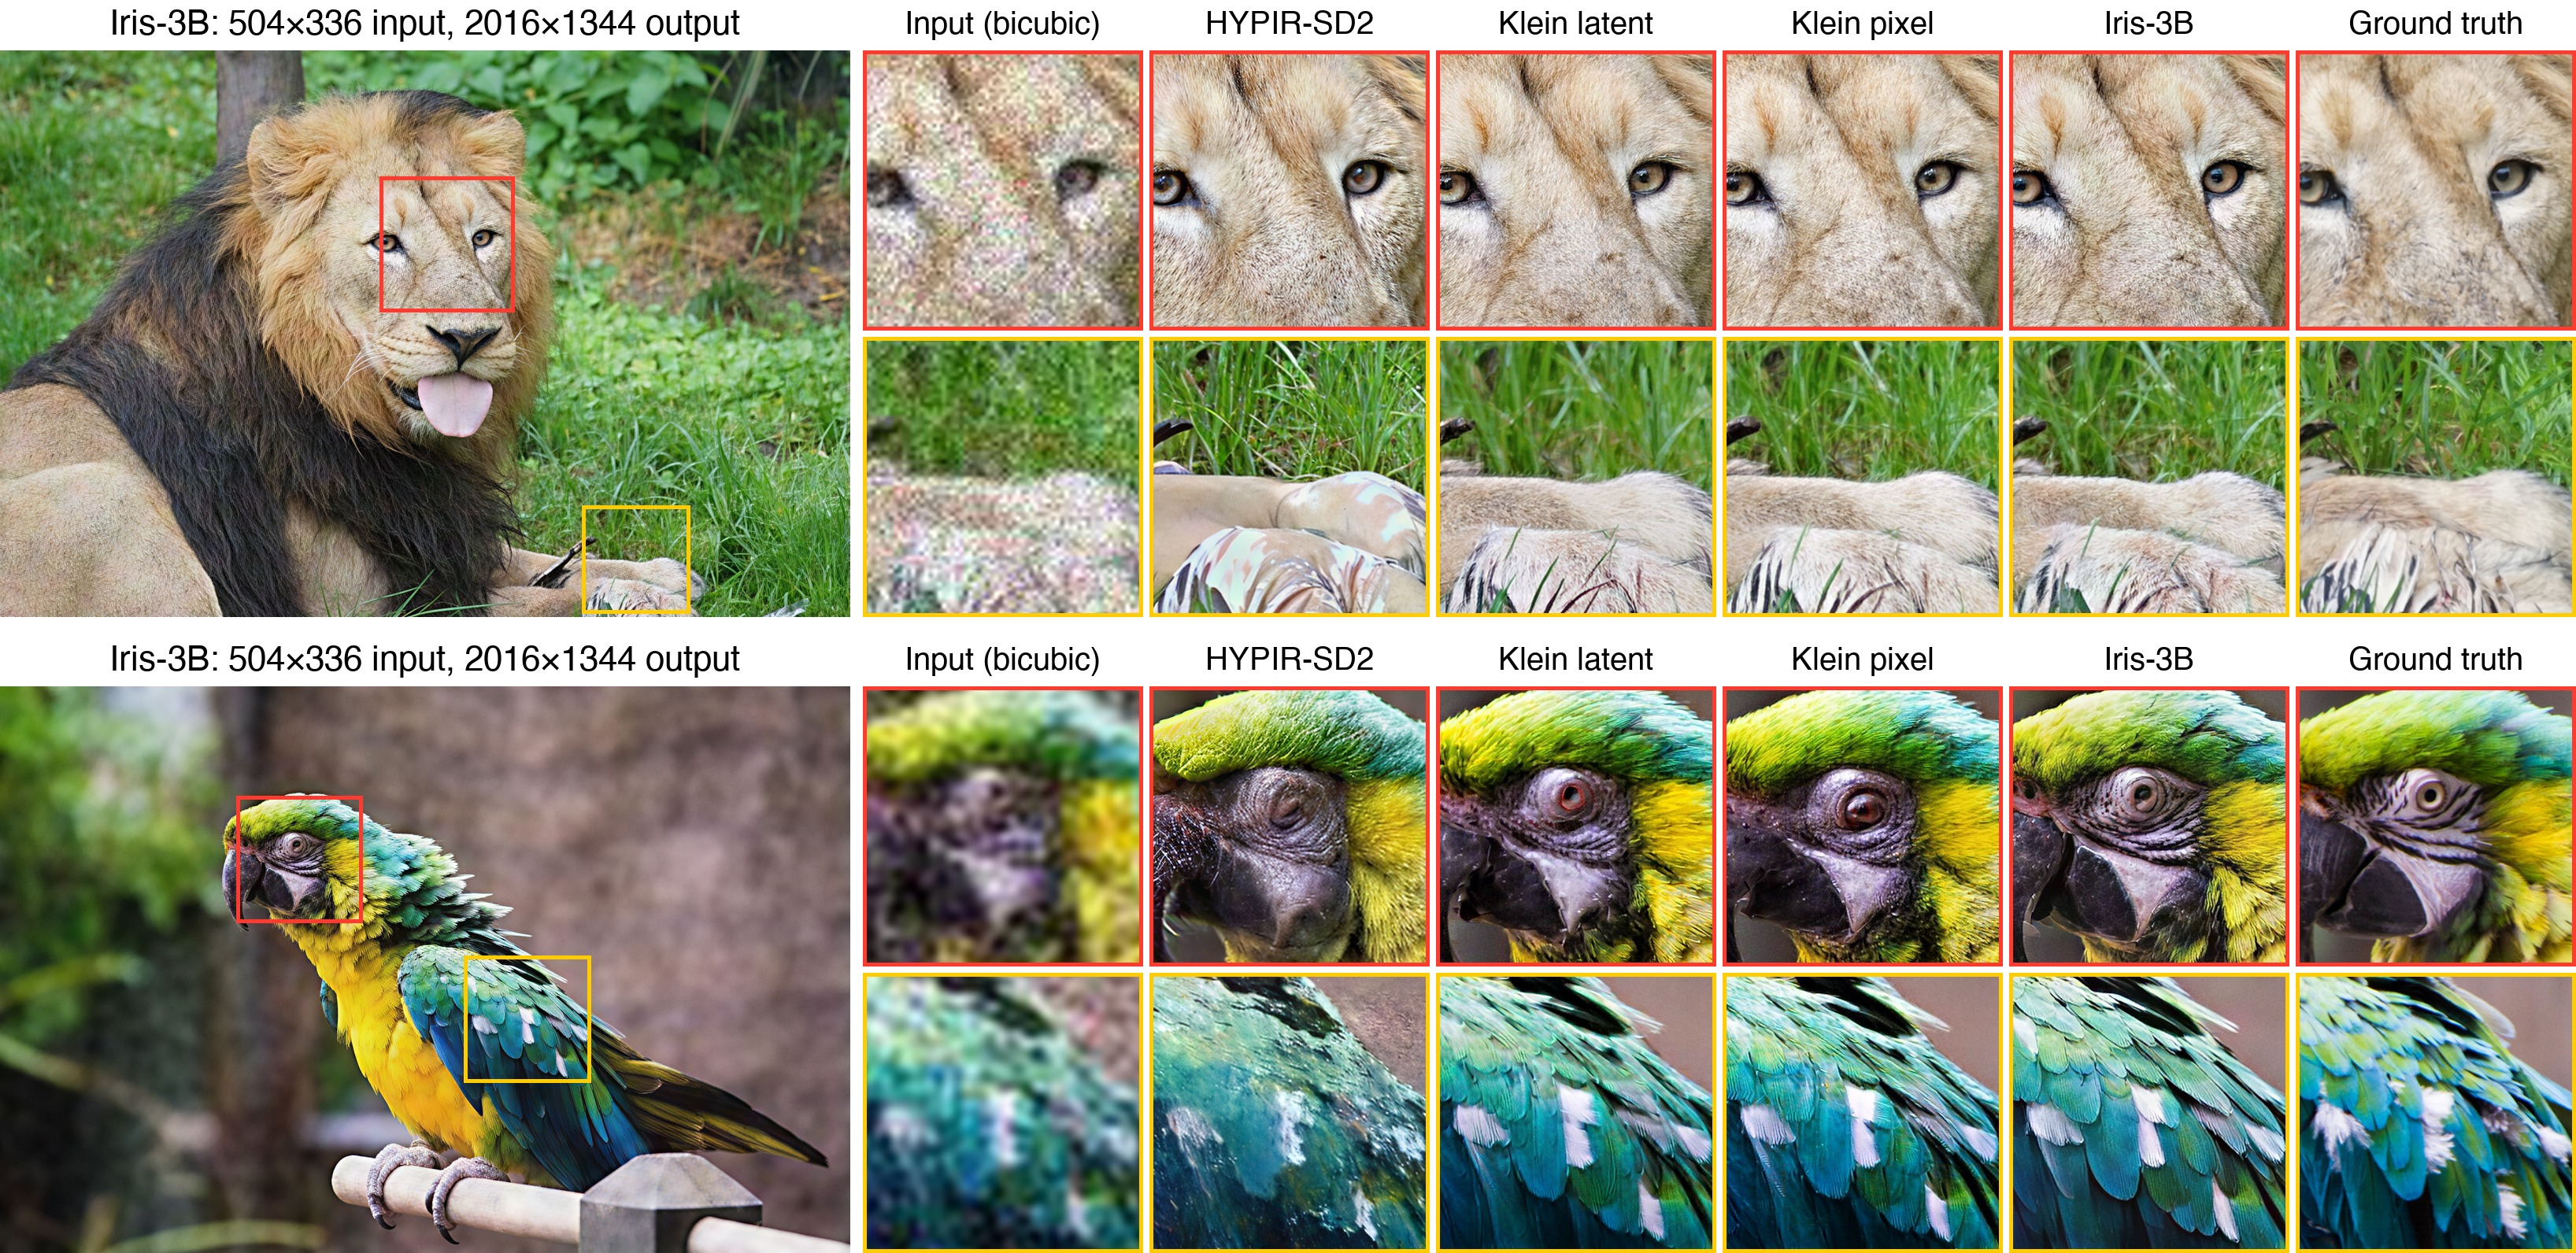
对复原任务的直接启示:预训练像素模型并没有自动带来更好的保真度。论文还在单目深度的原始输出中测到 16×16 patch 网格,Iris-3B 在所列数据集的边界曲率比约为 1.61 至 2.25,理想无网格接近 1。PiT 的跨 patch 交互经过压缩 token,相邻 patch 的像素在原分辨率上没有直接联合处理,边界仍是结构性问题。
结果说明了什么?
前两篇的消融支持各自的架构设计;Iris-3B 则把问题推进到像素生成先验的迁移表现。
| ImageNet 256² / PixelDiT-XL | FID ↓ | 说明 |
|---|---|---|
| Vanilla DiT/16 | 9.84 | 仅 patch token |
| 双层 + compaction + patch-wise AdaLN | 3.50 | 恢复可计算的像素分支 |
| 再加入 pixel-wise AdaLN | 2.36 | 逐像素调制 |
取自 PixelDiT Table 5。无 compaction 的双层模型在相同训练设置下显存溢出;完整模型训练至 320 epochs 后为 FID 1.61。
| ImageNet 256² / 480 epochs | FID ↓ | 预训练特征的作用 |
|---|---|---|
| 裸主干 | 2.19 | 无额外表征路径 |
| 仅 REPA | 1.73 | 训练时对齐目标 |
| 仅 grounding | 1.83 | 去噪时空间条件 |
| REPA + grounding | 1.59 | 两条路径同时启用 |
取自 PixelDiT2 Table 4;两条有效路径均使用 DINOv3-S/16。320 epoch 以后组合设置持续领先;早期 200 epoch 时 REPA 与组合设置的 FID 分别为 1.89 与 1.90。
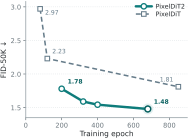
跨论文数字涉及不同模型尺寸、训练设置和采样器,适合作为论文报告的结果概览;增益的机制归因主要依据上方的受控消融。PixelDiT2 报告 256² 的 1.46 FID 使用 600 epochs、H/16 模型。
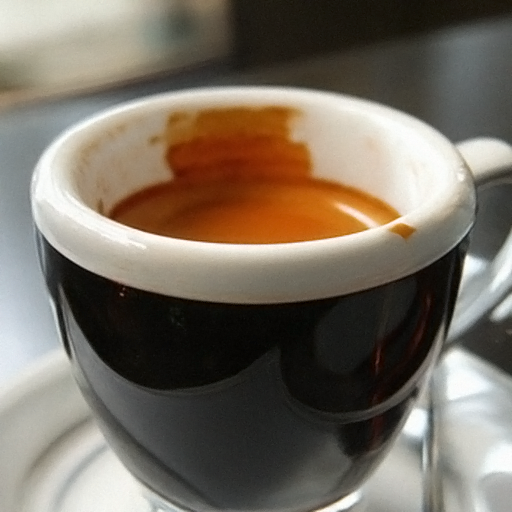
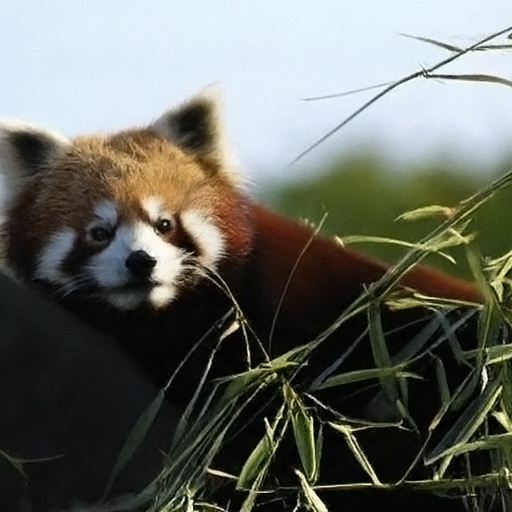
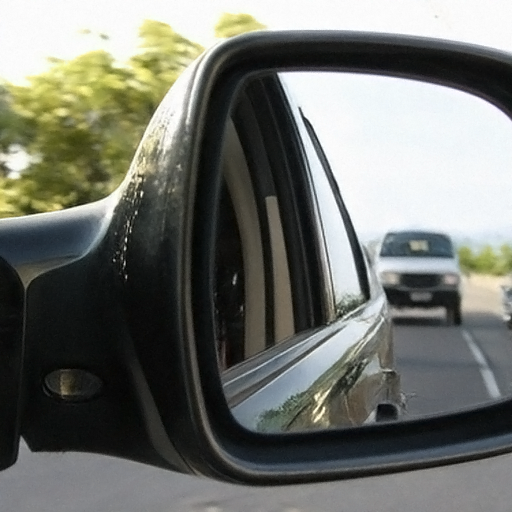
PixelDiT2 原论文 Fig. 1 的 ImageNet 512² 类别条件样本,均取自 arXiv 源文件。
PixelDiT 建立高效的逐像素建模,PixelDiT2 在去噪过程中持续引入预训练表征,Iris-3B 把 PixelDiT 的像素头扩展到大规模文字生图,并检验它的下游迁移。三篇工作共同留下的关键问题,是如何在保留生成先验的同时维持严格的像素对齐与跨 patch 连续性。